Token (IA) : définition
Aussi appelé : jeton, token de langage, unité de texte IA, tokenisation.
Mis à jour le
Rédigé par Karim Brahim
Définition
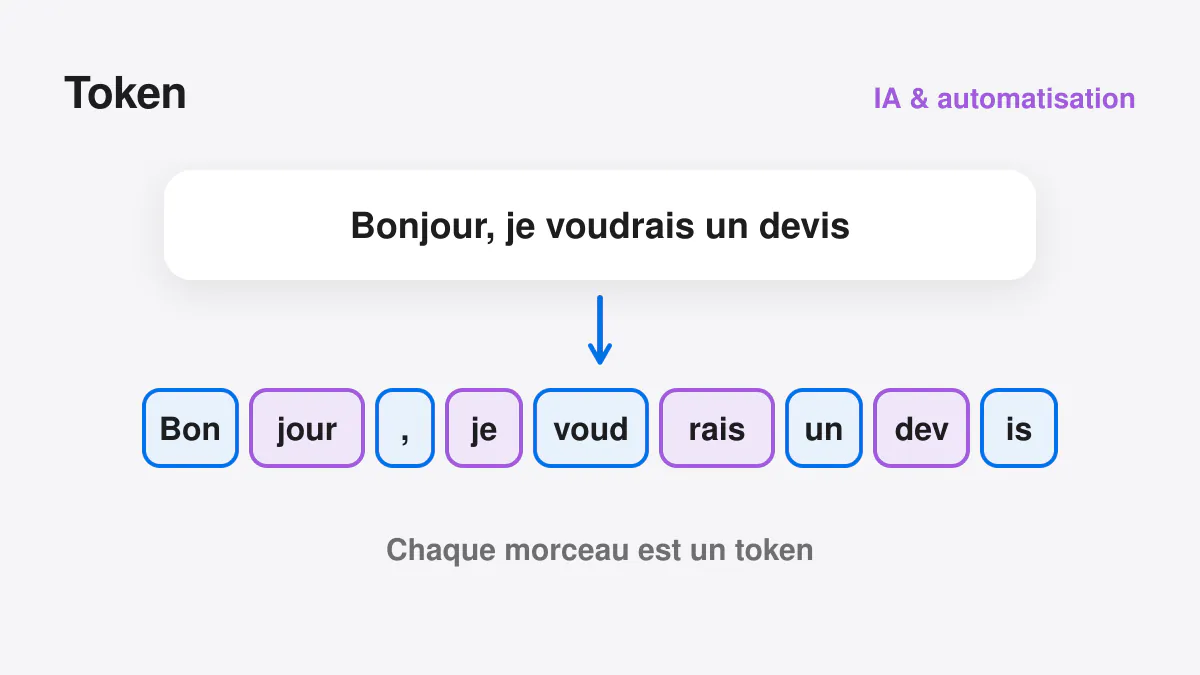
Un token est l'unité de texte traitée par un modèle de langage (mot, morceau de mot ou signe). Il mesure la capacité et le coût d'usage d'une IA.
Avant de traiter un texte, un LLM le découpe en tokens (on parle de tokenisation). « Bonjour » peut former un seul token, alors qu'un mot rare ou long comme « anticonstitutionnellement » sera découpé en plusieurs morceaux. Les espaces et la ponctuation comptent aussi.
En détail
Les tokens interviennent à trois niveaux :
- la capacité : chaque modèle a une fenêtre de contexte, un nombre maximal de tokens traités en une fois. Elle contient le prompt système, les documents fournis, l'historique et la réponse. Les modèles récents acceptent de très longs contextes, mais un contexte long coûte plus cher et peut diluer l'information importante ;
- le coût : les API de modèles de langage facturent au volume, en distinguant les tokens d'entrée (ce que vous envoyez) et les tokens de sortie (ce que le modèle génère), plus chers. Les prix sont exprimés par million de tokens et varient fortement d'un modèle à l'autre ;
- la vitesse : plus la réponse compte de tokens, plus elle met de temps à être générée.
Quelques techniques réduisent la consommation :
- la mise en cache des parties répétées du prompt, proposée par plusieurs fournisseurs à tarif réduit ;
- le RAG, qui n'envoie que les extraits utiles au lieu de documents entiers ;
- le résumé des longues conversations ;
- des consignes de concision et une limite de longueur de réponse ;
- le choix d'un modèle adapté : un modèle léger pour trier ou classer, un modèle puissant pour les tâches complexes.
Exemple (cas type)
Prenons l'exemple d'une agence immobilière qui prévoit un chatbot sur son site. Pour estimer le budget, elle calculerait la taille moyenne d'une conversation : prompt système, quelques extraits de fiches de biens remontés par recherche, cinq ou six échanges avec le visiteur.
En multipliant par le nombre de conversations attendues et par le tarif du modèle, elle obtiendrait une fourchette mensuelle. Elle pourrait activer la mise en cache du prompt système, limiter l'historique transmis et fixer un plafond de dépenses quotidien. Un suivi mensuel comparerait ensuite l'estimation à la consommation réelle.
Points d'attention
Le coût d'une IA se maîtrise en mesurant la consommation réelle, en plafonnant les dépenses et en n'envoyant au modèle que les informations utiles.
- Mesurer avant d'extrapoler : faites un test sur de vraies conversations pour estimer la consommation.
- Plafonner : fixez des limites par conversation, par jour et par mois pour éviter les mauvaises surprises, y compris en cas d'abus.
- Surveiller les prix : les tarifs et les modèles évoluent souvent ; réévaluez votre choix régulièrement.
- Ne pas tout mettre dans le contexte : envoyer des documents entiers coûte cher et n'améliore pas toujours la réponse.
- Prévoir l'échec : quand la fenêtre de contexte est pleine ou le budget atteint, l'assistant doit basculer vers une solution de repli.
Pour aller plus loin
Pour un ordre de grandeur des coûts d'usage, lisez notre article sur le prix d'un agent IA sur mesure. Dopinet dimensionne et plafonne la consommation de ses solutions d'automatisation par l'IA et de ses agents IA d'entreprise.